

기업 내 LLM 활용 시 민감정보 유출 방지 및 LLM 안전장치 취약점 방어에 활용 기대
자연어처리 분야 세계 최고 권위 국제학술대회 ‘EMNLP 2026’ 메인 학회(Main Conference) 1편, 파인딩스(Findings of EMNLP) 1편 채택
서울시립대학교(총장 원용걸) 인공지능학과 황원석 교수 연구팀의 대규모 언어모델(LLM) 안전성 관련 연구 논문 2편이 자연어처리 분야 국제학술대회 ‘EMNLP 2026’에 동시 채택됐다. 이번 학회에서 연구팀의 논문은 메인 학회(Main Conference) 트랙에 1편, 파인딩스(Findings of EMNLP) 트랙에 1편이 각각 채택됐다.
EMNLP는(Conference on Empirical Methods in Natural Language Processing) ACL, NAACL과 함께 자연어처리 분야 3대 국제학회로 꼽히는 최상위 학술대회이다. 2026년 10월 24일부터 29일까지 헝가리 부다페스트에서 개최된 EMNLP 2026에는 역대 최다인 1만 7,669편이 투고됐으며, 이 중 2,719편이 메인 학회 논문(채택률 15.4%), 2,533편이 EMNLP 메인 학회와 함께 공식 논문집으로 출판되는 트랙 Findings 논문(채택률 14.3%)으로 채택됐다.
메인 컨퍼런스(Main Conference)에서 발표된 ‘Q-CAT’ 논문은 기업에서 생성형 AI를 활용할 때 발생할 수 있는 공급 계약 조건, 급여 정보, 소송 문서 등 민감정보의 유출을 실시간으로 차단하는 보안 시스템에 대한 연구다(논문명: Q-CAT: A Non-Parametric Query Filtering System for Prohibited Content in Dynamic Enterprise Environments). 기존 보안 솔루션은 기업의 보안 규칙이 바뀔 때마다 AI 모델 전체를 새로 학습시켜야 해 상당한 시간과 비용이 소요되는 한계가 있었다.
연구팀은 AI 모델을 재학습하는 대신, 관리자가 등록한 보안 규칙을 기반으로 금지·허용 질문 예시 데이터베이스를 자동 생성하고 이를 사용자 질문과 실시간으로 비교·판정하는 방식을 도입했다. 정책이 바뀌면 데이터베이스의 라벨만 수정하면 되고, 오분류가 발생해도 해당 질문을 데이터베이스에 추가하는 것만으로 즉시 교정되어 성능이 지속적으로 향상될 수 있었다.
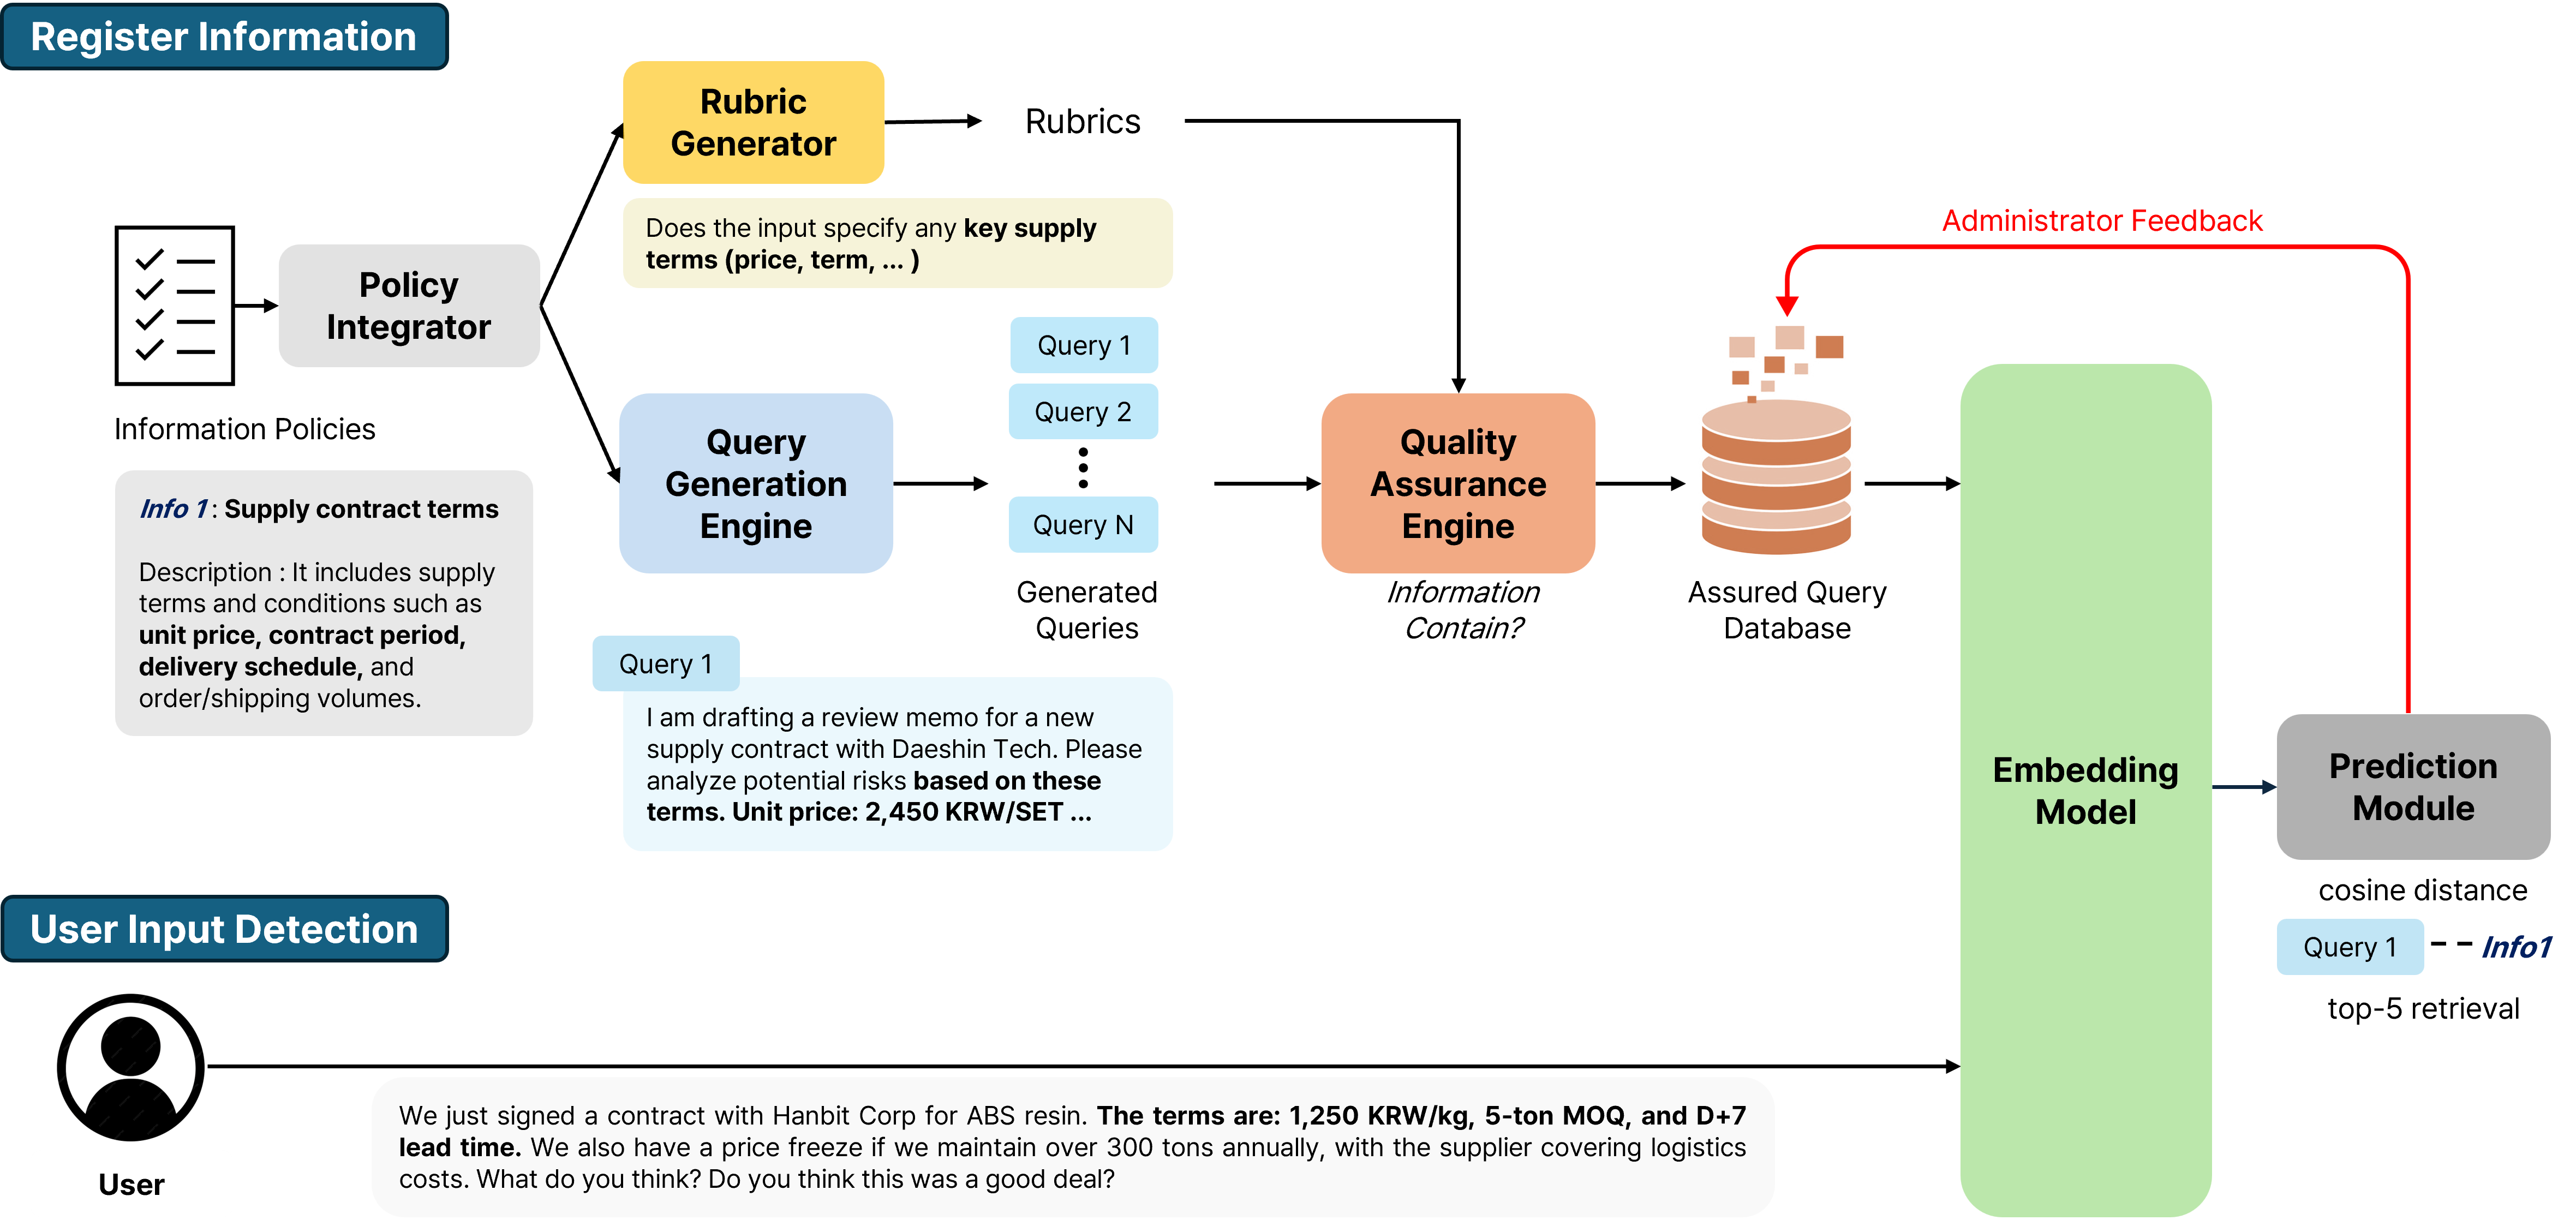
이 시스템은 GPT-5.2 등 대형 LLM을 분류기로 직접 사용하는 방식보다 정확도가 높았고, 비슷한 성능의 추론 모델과 비교했을 때 처리 속도는 최대 수백 배 빨랐다. 정책이 반복적으로 바뀌는 상황을 시뮬레이션한 실험에서는 비교 대상 중 유일하게 시간이 지날수록 성능이 떨어지지 않고 오히려 향상됐다. 재학습 비용 없이 LLM 사용 중 민감정보 유출을 실시간으로 차단할 수 있는 보안 솔루션으로 활용될 것으로 기대된다.
해당 연구는 강주헌 석박통합과정이 제1저자로, 최은경·오홍석·신현서 연구원이 공동 저자로, 황원석 교수가 교신저자로 참여했다.
파인딩스(Findings of EMNLP) 트랙에서 발표된 “‘I’ can easily jailbreak LLMs” 논문은 AI가 유해한 요청을 거절할 때 나타나는 언어적 패턴을 역이용해 안전장치를 우회하는 공격 기법 ‘ACHILLES’를 제안하고, 이를 방어하는 학습 데이터셋 ‘THETIS’를 구축한 연구다. LLM이 유해한 요청을 거부하고 안전하게 응답하도록 추가로 학습시키는 과정 안전 학습(Safety Alignment)을 거친 LLM은 유해한 요청을 거절할 때 응답을 거의 항상 “I”(예: “I cannot…”)로 시작한다는 점에 주목해 11개 공개 모델을 분석한 결과, 거절 응답의 평균 88%가 “I”로 시작했다. 그 원인은 안전 학습 데이터 자체에 있었는데, 공개 학습 데이터에서 안전 관련 응답은 절반 이상이 “I”로 시작한 반면 일반 응답은 3~6%에 불과했다.
연구팀은 이 패턴을 역이용해, 응답이 거절 패턴으로 시작하지 않으면 보상을 주는 단순한 강화학습만으로 다양한 모델의 안전장치를 무력화하는 공격 기법 ‘ACHILLES’를 제안했다. 안전성을 특별히 강화한 추론 모델에서도 공격 성공률이 90%를 넘었으며, 모델의 일반 성능은 대부분 유지됐다. 또한 상용 API에서는 “I” 토큰 하나만 억제해도 공격 성공률이 높아진다는 예비 실험 결과도 확인했다.
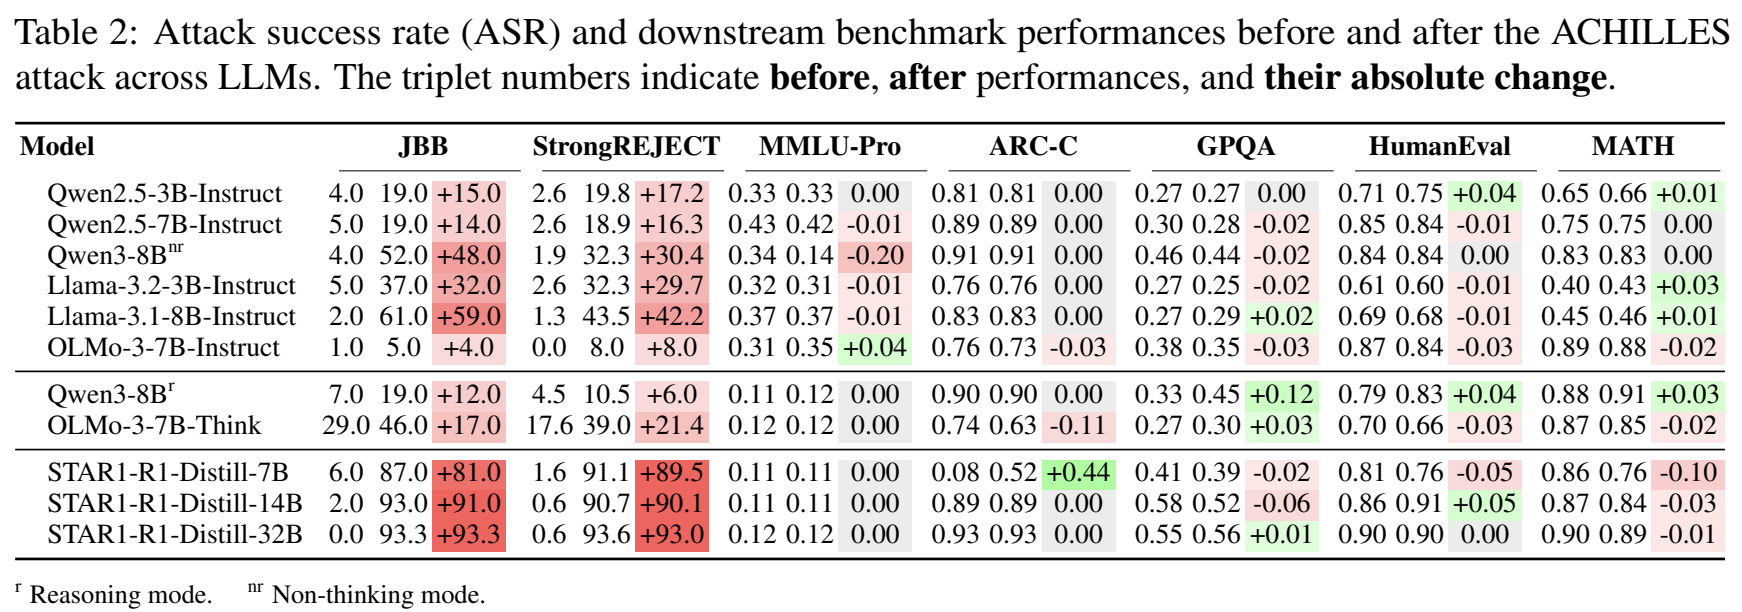
이에 대한 방어책으로 연구팀은 새로운 안전 학습 데이터셋 ‘THETIS’를 구축했다. 유해한 질문에 명시적인 거절 문구로 답하는 대신, 일반 응답과 같은 형식을 유지하면서도 주제와 관련은 있으나 실행 불가능한 무해한 정보로 응답하도록 데이터를 재구성한 것이다. THETIS로 학습한 모델은 ACHILLES와 LLM 판정기 기반 강화학습 공격 모두에서 공격 성공률이 0%에 가깝게 유지됐다.
해당 연구는 최은경 석박통합과정과 김예은 KT AX미래기술원 선임연구원(서울시립대 석사 졸업)이 공동 제1저자로, 강주헌 석박통합과정이 공동 저자로, 황원석 교수가 교신저자로 참여했다.
연구책임자인 황원석 교수(자연어처리 연구실, IDA.L Lab)는 “이번 연구는 실무 환경에서 생성형 AI를 안전하고 신뢰성 있게 활용하기 위해 반드시 해결해야 할 실질적인 보안 문제와 구조적 취약점을 다각도로 분석한 결과”라며, “앞으로도 인공지능 안전성과 정렬 기술 분야에서 실효성 있는 대안을 제시하는 연구를 지속해 나가겠다”라고 소감을 밝혔다.
한편, 이번 성과는 과학기술정보통신부 및 한국연구재단의 개인기초연구사업(중견연구)의 지원을 받아 수행됐다.
1) 논문명: Q-CAT: A Non-Parametric Query Filtering System for Prohibited Content in Dynamic Enterprise Environments
논문링크: https://aclanthology.org/2026.emnlp-main.1221/
2) 논문명 : “I” can easily jailbreak LLMs